
集成电路学院学子在FPL 2026展示FPGA+大模型加速新成果
2026年9月7日,在比利时举办的国际顶级会议FPL 2026(International Conference on Field Programmable Logic and Applications)上,我院2024级硕士研究生刘俊代表姚清河教授(双聘)团队展示了面向混合专家(MoE)大模型推理的双FPGA加速框架。

针对MoE部署中面临的内存瓶颈、负载不均和功耗高等问题,研究提出三项核心技术:一是基于平衡协同聚类的专家分组,通过专家亲和度与负载均衡优化,降低FPGA间通信;二是利用门控网络隐藏状态进行预测预取与分层缓存,隐藏内存访问延迟;三是面向prefill和decode不同阶段的感知调度,动态均衡负载。团队还构建了cycle-accurate MoE仿真器,在Qwen1.5-MoE-A2.7B、双Xilinx U280 FPGA上进行模拟仿真,相比NVIDIA A800、V100和64核CPU分别取得1.53×、1.81×和3.83×加速;消融实验与OLMoE的三FPGA扩展结果也验证了方案有效性。
在具体实现上,团队针对MoE模型路由动态多变的特点,设计了轻量级预测器。该预测器利用门控网络(Gate)给出的当前层隐藏状态,预测下一层将被激活的Top-K专家。若预测命中,则直接复用片上缓存的权重,大幅减少访存开销;若未命中,则按需从HBM读取,并采用层自适应策略,为预测精度较低的层分配更大的缓存空间,从而有效隐藏内存访问延迟。

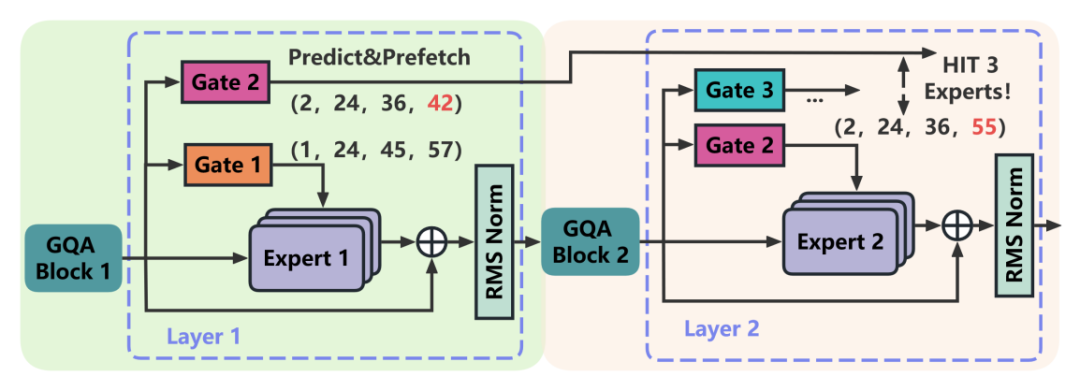
预测预取机制图(Predict & Prefetch)
针对多FPGA间的通信瓶颈,团队提出了分阶段感知调度策略。在Prefill阶段,通过专家分组进行均衡的Token分配,最小化跨片通信;在Decode阶段,调度器实时监测3:1甚至4:0的严重负载不均模式。对于3:1不平衡,重载节点计算部分矩阵后,通过QSFP将中间结果传输至轻载节点并行计算;对于4:0极端不平衡,则采用分段传输部分运算,让轻载节点渐进处理计算。这种机制确保了整体延迟由重载工作量主导,而非通信开销。
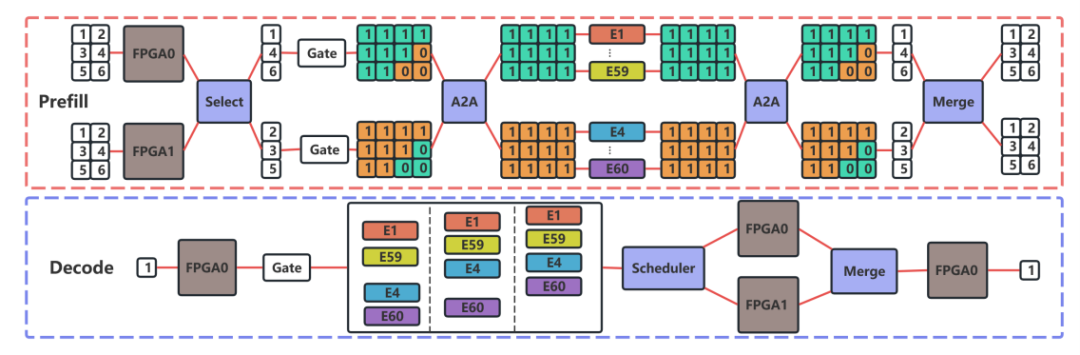
通信机制与负载均衡图(Inter-FPGA Communication)
在硬件部署与评估方面,该系统基于双Xilinx Alveo U280 FPGA实现,采用W8A8训练后量化。结果展示图显示,系统在多种批大小和序列长度下,相比A800、V100和CPU均取得显著加速。消融实验进一步证明了各模块的有效性与正交性:单独使用分组加速1.103×,单独调度加速1.190×,组合预测与缓存后整体加速达1.363×。此外,在OLMoE模型上,三FPGA配置达到了1.441×的扩展加速比,充分展现了该框架向更大规模多FPGA集群扩展的潜力。
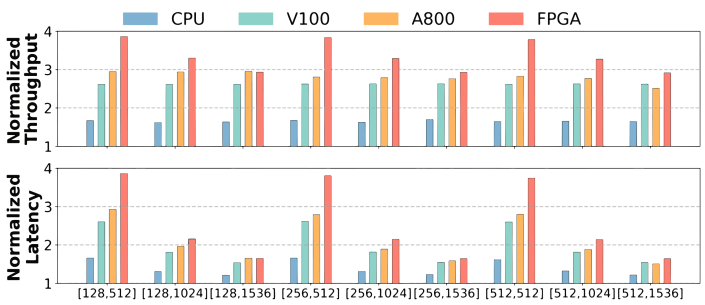
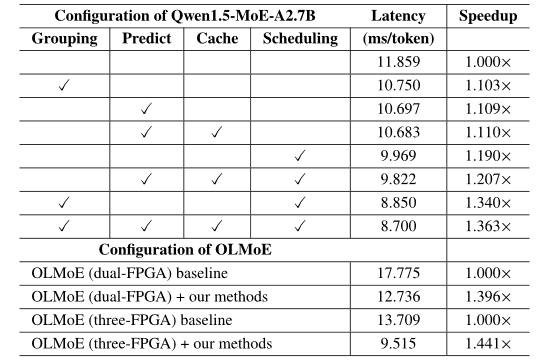
结果展示图(Evaluation)
FPL是可编程逻辑与可重构计算领域历史最悠久、规模最大的国际学术会议,也是FPGA领域公认的四大顶级会议之一。自1991年创办以来已走过35年历程。该会议是IEEE赞助的旗舰会议,见证了FPGA架构、EDA工具、异构计算等关键技术从实验室走向产业化的全过程。在学术评价体系中,FPL被列入CCF C类会议(计算机体系结构/分布式计算方向)、ICORE B类会议及QUALIS A2类会议。会议录用标准严格,录用率为28% - 37%,审稿采用“双盲+rebuttal”机制,保障评审公正性。本次参会成果也得到了王美琪副教授的支持和指导。
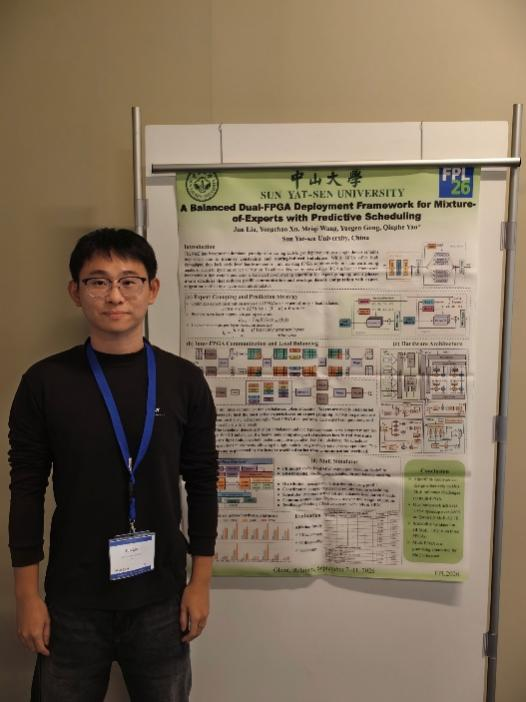
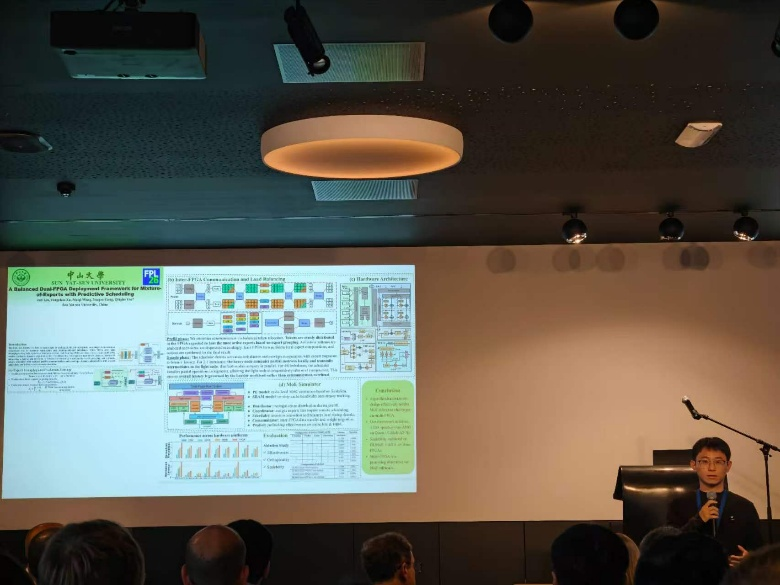
会议现场
此次参会不仅是研究成果的展示,更是一次宝贵的国际学术交流训练。学院鼓励更多同学主动关注并参与国际高水平会议,把课堂与实验室中的工作带到更广阔的学术舞台,在投稿、海报展示、口头报告和问答交流中开阔视野、结识同行、打磨研究。学院也将持续为同学们提供信息、指导与支持,期待我院未来有更多学子在国际学术舞台上发出声音、展示风采。